Предпочитаете видео? Для этой статьи есть видеоверсия:
Я ненавижу Word. Поэтому сделал это.
Я ненавижу Word.
А так же его клоны: OnlyOffice, WPS Office, а LibreOffice среди них, наверное, самый неудобный и перегруженный.
Чем же плохи docx редакторы?
Ничем, они классные (я шиз, статью заканчиваем).
Ладно, претензия была относительно написания студенческих работ, таких как лабораторная, отчет по практике, курсовая и тем более диплом. В Word ты занимаешься оформлением, а не содержанием документа.
Но многие поколения как-то писали работы в Word, и я тоже писал.
На первом курсе университета нас учили работать в Word и я тогда думал, ему нет альтернативы, это был общепринятый стандарт, ниспосланный богами Microsoft, поэтому весь бакалавриат я писал и страдал, переписывал, узнавал, откуда у меня руки растут и что с этим делать, особенно больно было после перехода на Linux и смены программы на LibreOffice и WPS Office.
Тогда же я занялся написанием дипломов и курсовых для других, увеличив свои страдания кратно. Тут хотел бы отметить, как ни странно, даже умные ребята заказывали работы, хоть им и было о чем писать, но рутина оформления отбивала все желание.
На последнем курсе я, естественно, взял с десяток дипломов в довесок к своему (я очень люблю страдать ОЧЕНЬ). На нормоконтроле диплома я потратил несколько дней и ночей бесконечных переписываний и... решил продолжить пытки, пойдя в магистратуру.
И только в магистратуре, став достаточно смелым, прекратил эти абьюзивные отношения. И решил сразу найти замену ушедшей девушке ушедшему из моей жизни ворду.
Альтернатив было по большей части две: LaTeX и Typst
LaTeX - стандартое и надежное решение типографических задач, он имеет кучу пакетов, примеров и обучающего материала, а так же мощно автоматизирует рутину по выставлению нумерации, ссылок, стилей, подписи титульников и т.д.
А Typst быстрый и молодой инструмент с простым синтаксисом, написанный на Rust (ЛУЧШЕМ ЯЗЫКЕ В МИРЕ, ДАВАЙТЕ ВСЕ ПЕРЕПИШЕМ НА НЕГО).
Но после пробы:
Typst показался совсем незрелым и со слабым комьюнити, я все никак не понимал, как правильно писать тот или иной блок, документация не помогала (skill issue знаю), плюс к этому ИИ на нем жутко галлюцинировал, пытаясь писать LaTeX вместо Typst.
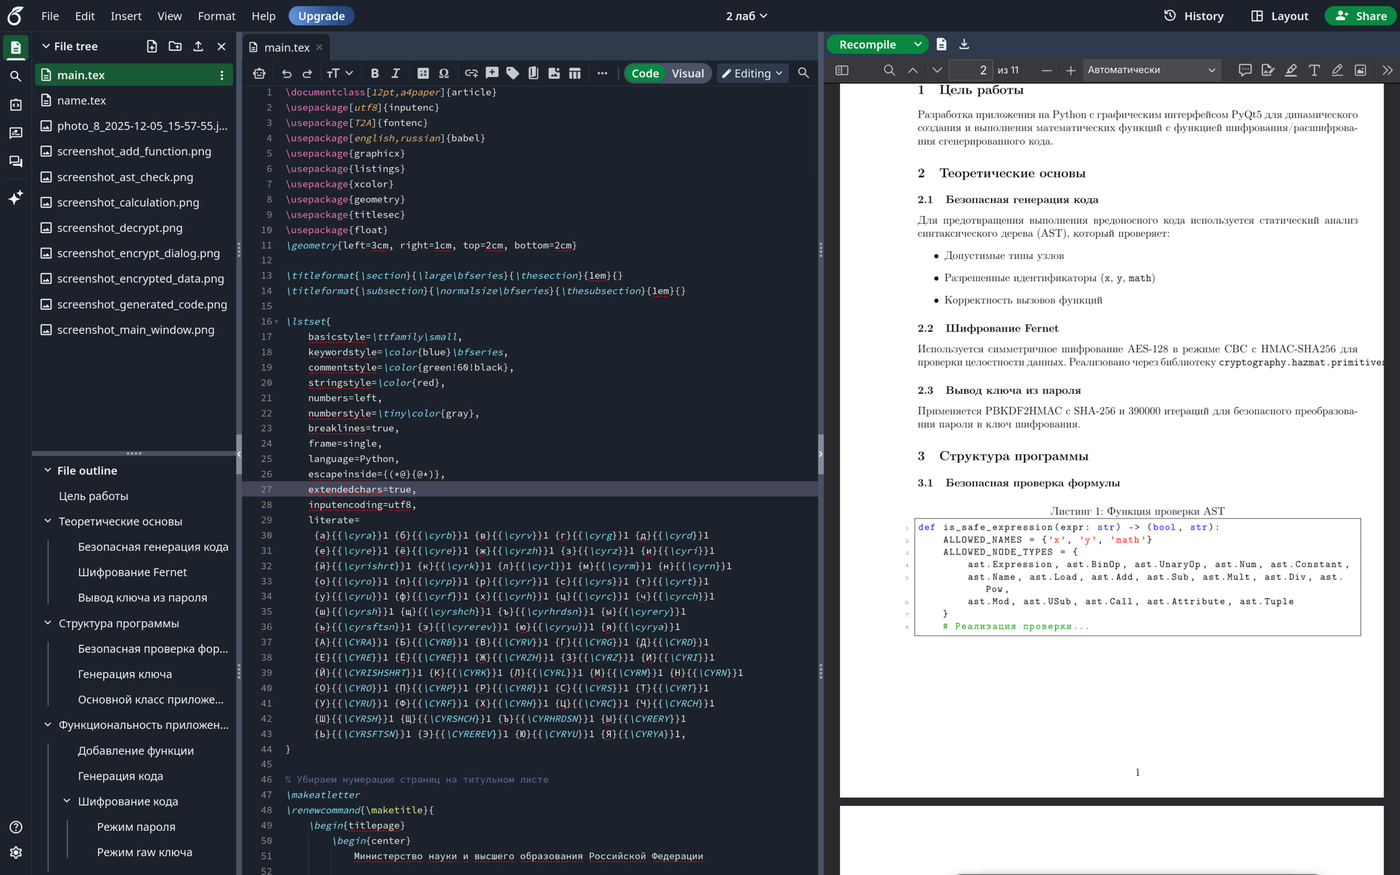
Поэтому я выбрал LaTeX, сделал на нем отчет по лабораторной и пошел его сдавать и, так как сдача была с экрана монитора, препод сильно удивился, что я показываю ему pdf, а не docx, и ему показалось, что я свистнул отчет у кого-то другого (хоть на титульнике и была моя фамилия, но это же не доказательство правда?), а связи в тот день как назло не было, и Overleaf, где я писал работу открыть с исходниками отчета я не мог, пришлось признать поражение и пересдавать в другой день.
Тут-то я понял, что обязательно требуется средство для вывода в docx, потому что Word проклятый монополист, и многие других методов написания документов в глаза не видели (даже если это кандидаты технических наук).
Но при этом LaTeX был удобен тем, что ChatGPT хорошо его генерировал, поэтому этот критерий я оставил как один из ключевых в своих последующих поисках.
Вообще всеми любимый GPT перевернул игру и вывел мою работоспособность на новый уровень, превратив эту работу буквально в кнопку БАБЛО. Но ИИ при всем при этом плохо генерировал docx напрямую и даже сегодня: самые мощные модели требуют кучи лимитов, чтобы сгенерировать хороший docx, потому что делают это через библиотеки языков программирования упрощающие манипуляции с языком разметки вордовских файлов, а в редких случаях правят напрямую язык верстки, и об оформлении в таком случае лучше забыть, особенно если вы не готовы к долгим переделкам, которые все равно упрутся в лимиты.
Поэтому я подумал, что нужен инструмент, не дающий ИИ каждый раз генерировать код с нуля, но и при этом упрощающий работу с версткой.
Тут-то я и решил сделать свой инструмент, зная всего полторы команды на Python, но я и Deepseek (да им можно не только ролить) справились с этой задачей.
Входными данными я решил сделать текстовый формат json, потому что я тогда думал, что ИИ хуже генерирует просто текст, мне казалось, json он генерирует быстрее (как же я ошибался).
Утилиту я назвал json2docx.
Писал я её на python, а для работы с xml взял python-docx.
Довольно быстро был сделан прототип и проверен на ближайшей курсовой. По итогам этого: моя работа упростилась раза в 3, хоть и пришлось дорабатывать документ руками, но и это был прорыв.
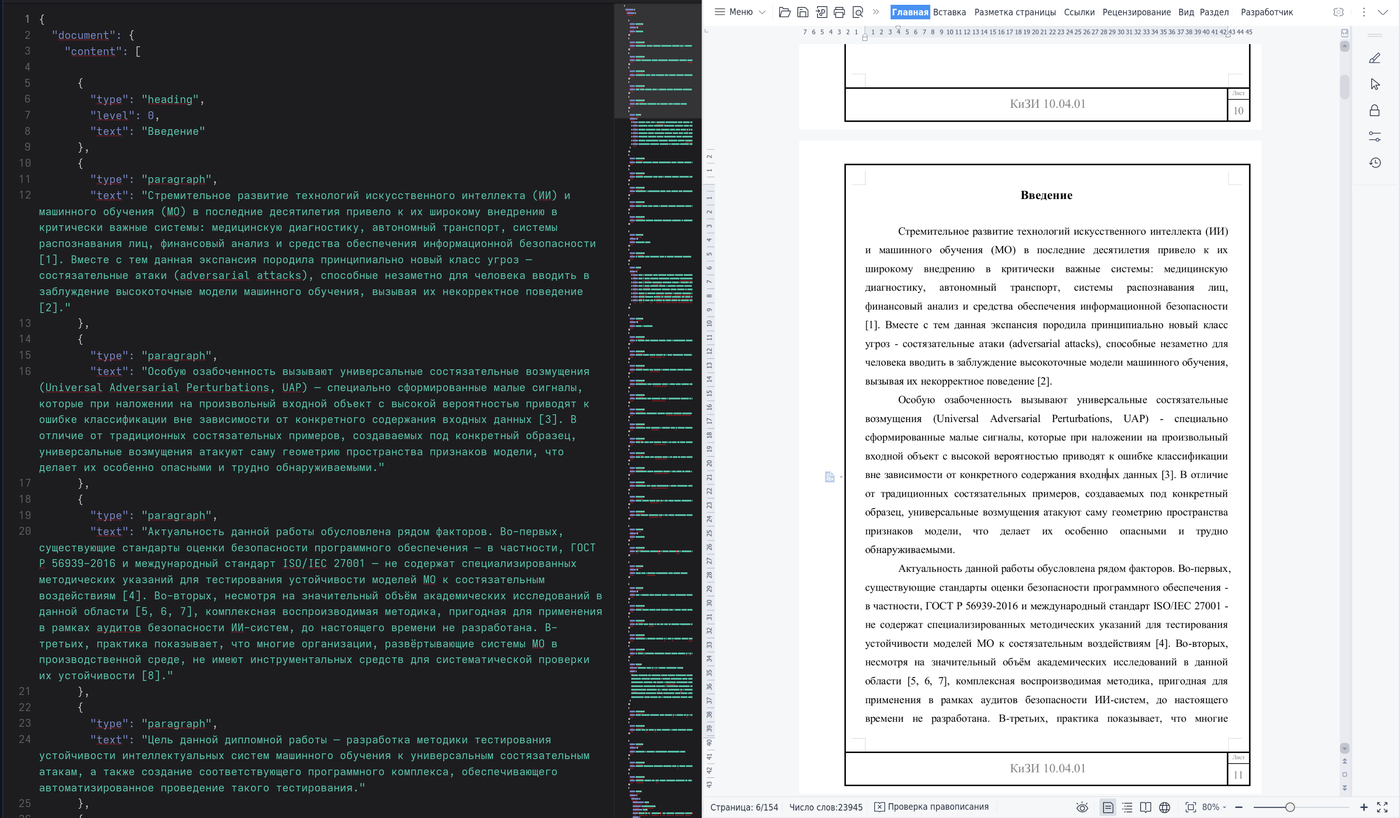
Но библиотека не покрывала всех элементов вордовского документа, поэтому json2docx довольно быстро оброс прямыми манипуляциями с xml. Типа таких:
def replace_in_xml_element(element, replacements):
    """
    Пробегает по XML-дереву элемента (lxml) и заменяет текст в тегах w:t.
    Это позволяет захватить текст внутри текстбоксов / shape'ов.
    """
    for node in element.iter():
        # namespace-aware: теги вида '{...}t'
        if node.tag.endswith('}t') and node.text:
            text = node.text
            for placeholder, value in replacements.items():
                if placeholder in text:
                    text = text.replace(placeholder, value)
            node.text = text
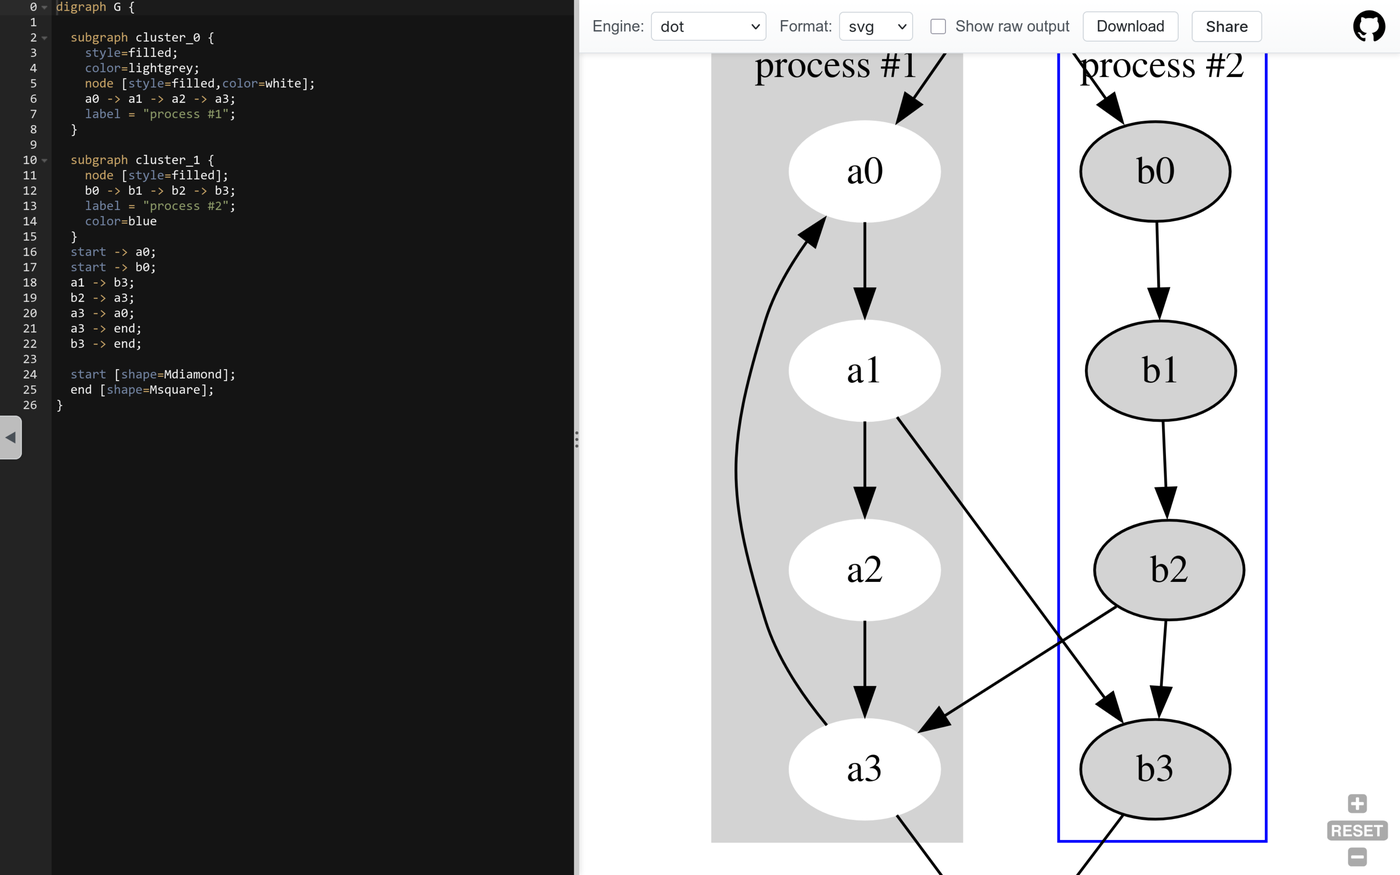
Но в работе кроме текста требовались блок-схемы, графики и диаграммы. Тут я узнал о библиотеке Graphviz, позволяющей языком dot описать блок-схемы и диаграммы, для графиков выбрал matplotlib, позже я добавил kroki — бэкенд, который поддерживает большинство таких языков для всевозможной графики через код. Так я добавил блоки изображений в свой диалект, которые мог генерировать ИИ, а json2docx рендерил и сразу вставлял их в документ.
Были еще формулы, и с ними тоже были сложности. Напрямую писать вордовский формат формул ИИ умели плохо, но была экспериментальная библиотека переводящая LaTeX в формулы вордовского формата, после нескольких проб я понял, что часть элементов не рендерилась, а давала билеберду, но я нашел выход: рендерить фото LaTeX формул и вставлять в документ.
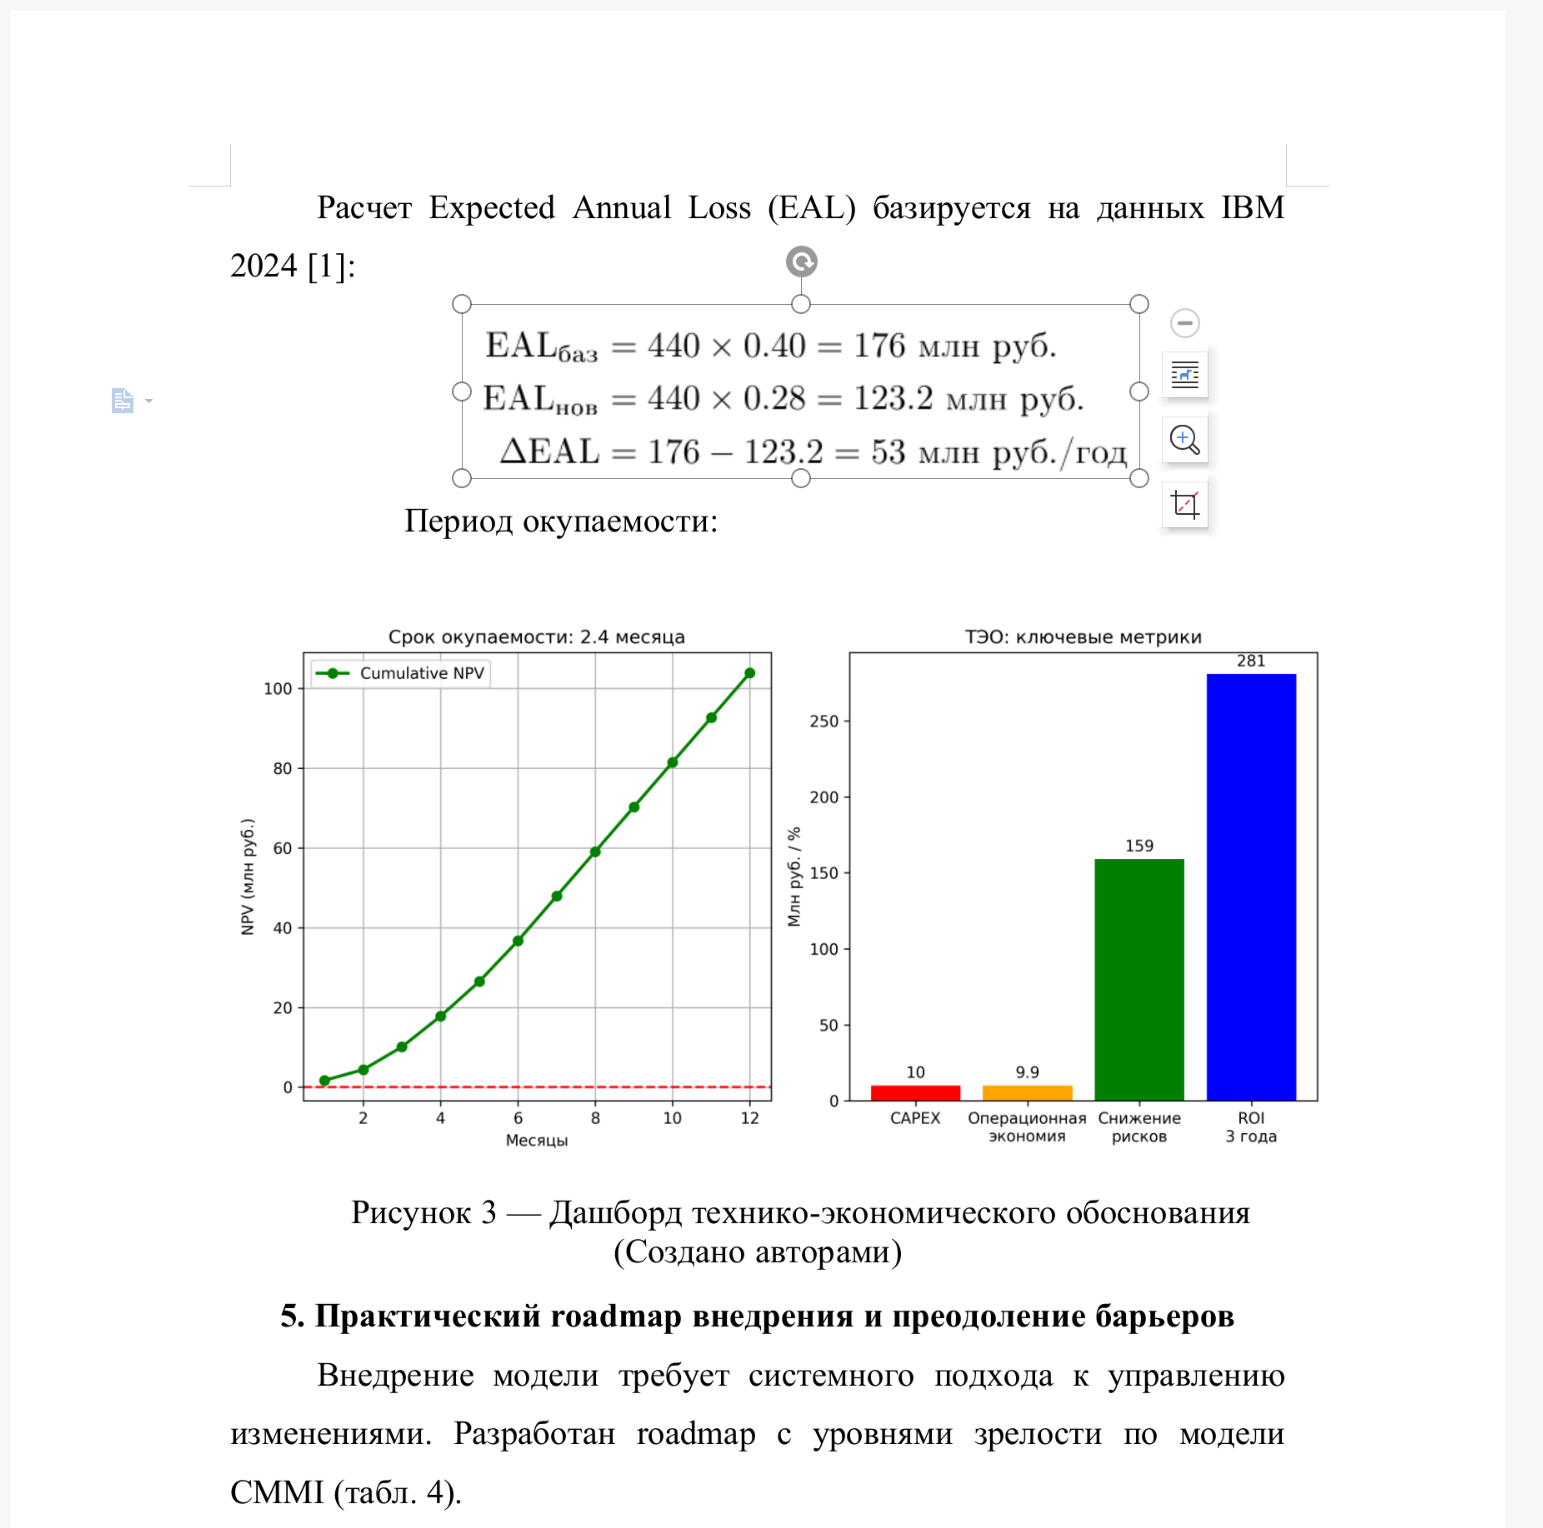
Я уже думал, что это всё - победа, но как бы не так, потребовалась утилита обратной конвертации json из docx, чтобы дать ИИ для анализа не только текст, но и понимание, для каких элементов какой стиль, так генерация стала точнее.
Пример оформления одного из стилей на тот момент:
"styles": {
        "heading": {
          "font_name": "Times New Roman",
          "font_size": 16,
          "bold": true,
          "italic": false,
          "font_color": "#000000",
          "alignment": "center",
          "first_line_indent_mm": 0,
          "line_spacing": 1.5,
          "space_after_pt": 0
        },
		<...>
	}
Я сделал docx2json.
Так уже инструменты породили удобный цикл: попросил ИИ написать работу -> отрендерил -> попросил поправить документ и снова отрендерил, повторял пока не получал хороший результат.
Через десяток работ я понял, что полностью отдавать выбор стиля на ИИ — это лишняя трата лимитов и добавление хрупкости из-за ошибок генерации стилей (опять же ИИ тогда галлюционировали больше, чем сейчас), поэтому я стал жестко задавать стили для каждого типа элемента (заголовка, абзаца, подписей рисунков и таблиц и других), но возможность ручных стилей для конкретного элемента еще оставлял.
Так прошел первый год проб, ошибок и доработок.
На второй год я открыл для себя claude code и тут был прорыв: можно было четко описать, что требуется по структуре и содержанию работы, и получить результат практически без галлюцинаций, а если и были, валидатор их ловил без проблем, работы получались отличные, но я не замечал слона в комнате... ЛИМИТЫ.
Лимиты кончались на подписке Pro очень быстро, а цены поднимать, чтобы окупать Max самый лучший месседжер из когда либо созданных подписку не очень-то хотелось.
Решено было оптимизировать трату токенов и первым под нож пошел json как очень многословный. Кроме траты лимитов это увеличивало контекст и вследствие этого ухудшало качество содержания работы. Поэтому я перевел инструмент с json на его более лаконичного "брата" yaml.
Так трата лимитов упала до 50% от изначальных, и работать стало приятнее, без бесконечных перебивок на покурить (я не курю, поэтому еще грустнее), а из-за читаемости yaml можно было даже писать такой документ руками.
Освободившийся контекст я решил заполнить еще несколькими инструкциями, написал валидатор не только по синтаксису, но и по содержанию, который claude использовал после каждой главы, и спецификацию для написания любых академических работ (что спросить у пользователя и в чем отказать).
Также сделал скрипт проверки источников с ИИ на их существование, так как даже claude без веб запросов придумывал (совсем дурашка), но главное, скрипт был адаптирован под проверку наших ГОСТов и нормативных документов (в чем он ошибался чаще всего).
Так как концепция перестала быть просто конвертацией между форматами, а обрастала еще содержательными правилами, то название стало docx-automation. Вот, кстати, это репо со спеками, диалектом yaml, валидатором и скриптом проверки источников — docx-automation.
В целом инструмент вместе с claude code стал просто комбайном академических работ (НОВАЯ БОЛЕЕ КРУТАЯ КНОПКА БАБЛО)
Так как не успевал помочь всем желающим, я хотел все же выпустить публичную версию инструмента, доступную неискушенному в коде пользователю, чтобы у них появлялся шанс сдать неплохую работу и ДАТЬ МНЕ ЕЩЕ БОЛЬШЕ ДЕНЕГ (на самом деле меньше).
Для не-программиста yaml — абракадабра, которой никто в здравом уме писать диплом не будет. Вот пример:
document:
  type: section
  content:
    - type: heading
      level: 0
      text: Реферат
    - type: paragraph
      text: "Документ содержит {PAGES} с., {IMAGES_COUNT} рис., {TABLES_COUNT} табл., {SOURCES_COUNT} источников."
    - type: heading
      level: 1
      text: Анализ предметной области
    - type: paragraph
      runs:
        - text: "Обычный текст, затем "
        - text: "полужирный"
          bold: true
        - text: " и "
        - text: "курсивный"
          italic: true
        - text: " фрагменты внутри одного абзаца."
    - type: heading
      level: 2
      text: Подраздел
    - type: paragraph
      text: "Абзац внутри подраздела. Нумерация заголовков (1, 1.1, 1.1.1) проставляется автоматически — в тексте её писать не нужно."
Кто-то из менеджеров или экономистов захочет писать так? Возможно врачи стали бы, им писать на мертвых языках не впервой.
Ещё одним минусом было постоянное прописывание тегов type, text и т.д.
Нужна была возможность писать это проще и нагляднее.
Поэтому был выбран более дружелюбный Markdown, простой, зрелый и проверенный язык разметки. Плюсом он позволяет встроить рисунки, формулы, таблицы и ссылки, что как раз кстати.
Но Markdown не идеален. О соблюдении ГОСТ 7.32 и ГОСТ 2.105 в таком документе речи и не идет, потому что этот язык не заточен под ГОСТ, требовались расширения диалекта под написание академических работ.
Я снова переписал свое ядро на прием Markdown вместо yaml. Хотя прокладка была бы более надежным решением, но я многое хотел поменять в ядре, сделать более модульным и убрать хардкод стиля под свой вуз.
Так добавилась еще полезная фишка — стили, в которых можно гибко настроить стиль под свою кафедру/журнал/новый стандарт.
Дальше был написан фронтенд (Claude и ChatGPT помогли, естественно), а бэкенд — моими кривыми ручками. Конвертация так же шла через библиотеку python-docx. Было решено, что нужно превью налету как у Overleaf, поэтому нужна была сборка docx в pdf, для этого используется LibreOffice...
Подружить его с решениями, которые работали в Word было той еще задачей, но я справился, и даже придумал как заставить рендериться docx почти 1 в 1 во всех клонах Word (с учетом что шрифты не заменяются на неидеальные аналоги).
В итоге редактор с превью стал важной функцией, позволяя на лету смотреть, что получается, и править размеры таблиц, формул или изображений, что ИИ часто может делать гиганскими.
Проведя несколько экспериментов с написанием работ через сервис и поправив баги я выпустил в прод сайт Оформитель, который позволяет сделать документы под ГОСТ или кастомные стили в docx и pdf.
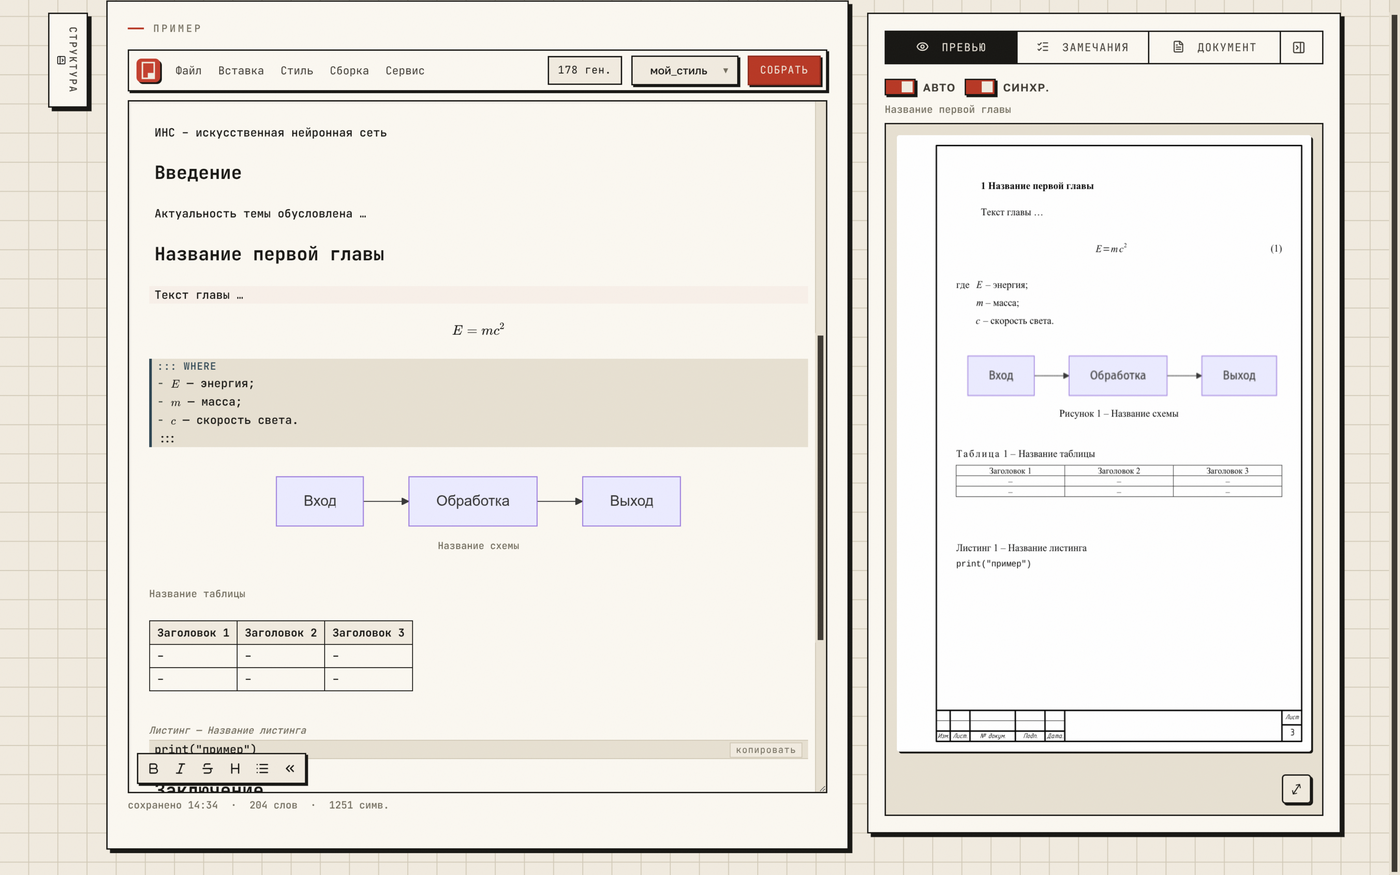
Можно очень гибко настроить стиль. Настолько гибко, что в какой-то момент я изучил, что такое капитель, реализовал её поддержку и потратил на это несколько часов жизни. До сих пор не уверен, что она понадобилась хоть кому-нибудь кроме меня.
Также в процессе тестирования добавил поддержку рамок, корректно оформленных блоков "где" для формул и других фишек, помогающих забыть об оформлении и сосредоточиться на содержании (или отдать это на аутсорс ИИ).
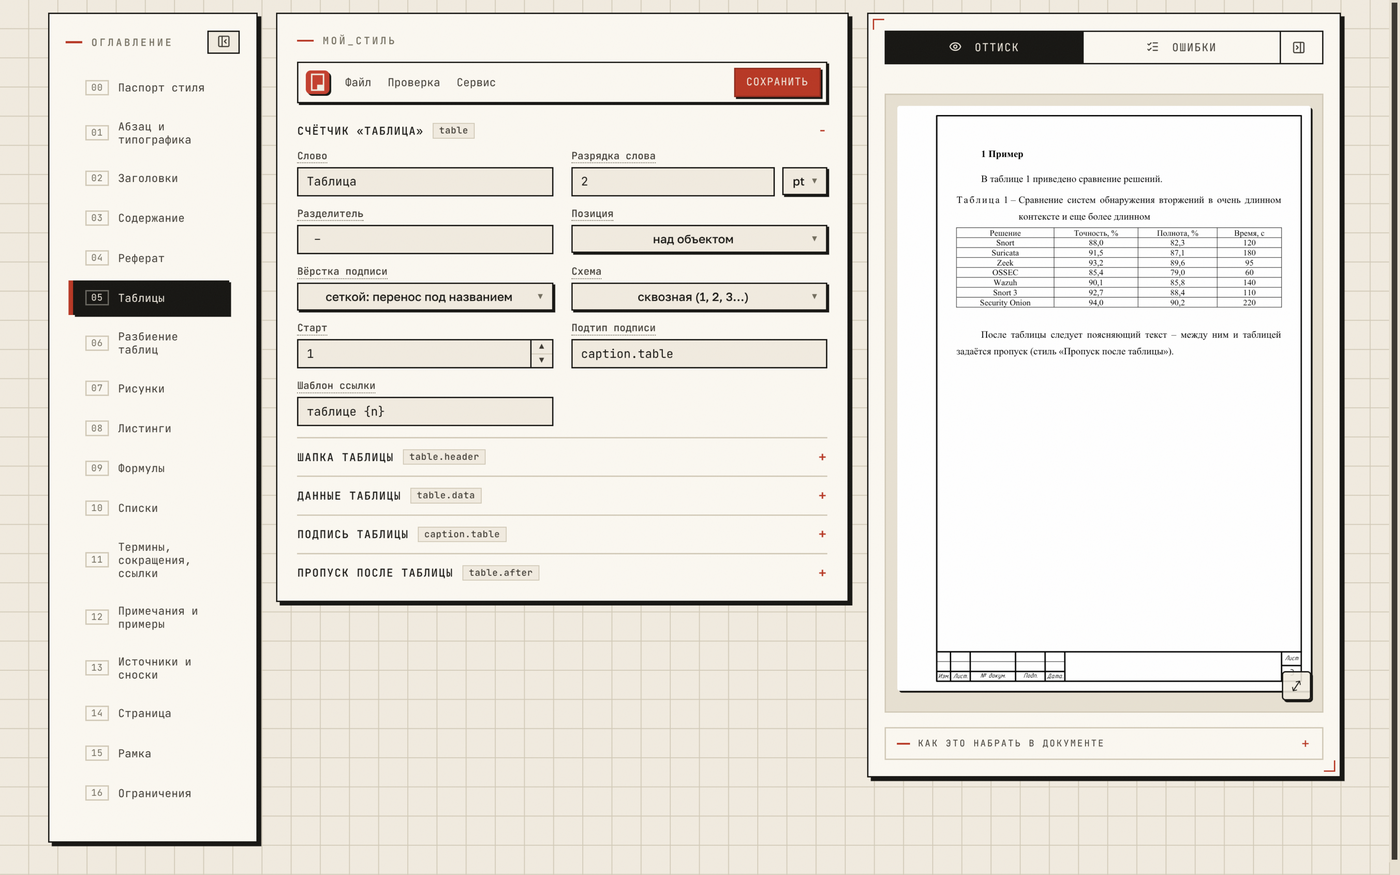
Буду рад, если кто-то потыкает сервис и найдёт баг или будут предложения по улучшению, попробовать могут все желающие, так как всё до генерации готовой работы в docx/pdf бесплатно, писать отзывы можно в сообщения канала Telegram-надеюсь-пока-не-запрещен, прекрасно если запишите видео или сделаете фото с пояснением проблемы/идеи.
Разбор всех фишек и доработок Оформителя я опишу как-нибудь в других статьях.
Все мои эксперименты — от json2docx до Оформителя — были попыткой дать студенту сконцентрироваться на содержании, а не оформлении.
И, возможно, этот инструмент поможет кому-то избавиться от страха оформления работы и даст волю своим идеям на бумаге (может даже не прибегая к помощи ИИ, но это уже звучит как научная фантастика).
Читайте также
- Как писать диплом в Markdown и конвертировать в Word по ГОСТ
- Как оформить диплом (ВКР), написанный ИИ, по ГОСТу
- Как написать диплом с ChatGPT и оформить его по ГОСТ
- Как написать курсовую работу с ChatGPT и оформить её по ГОСТ
- Как написать отчет по практике с ИИ (ChatGPT) и оформить его по ГОСТ
- Как написать лабораторную работу с ChatGPT и оформить её по ГОСТ
- Открытые исходники: диалект Markdown и примеры работ — GitHub